«Коммерсант»: в МИФИ учат нейросеть читать Псалтырь
24
сентября
2026
Какие возможности открываются перед филологами-древниками благодаря появлению технологий работы с большими данными? Что мы можем узнать нового, например, о языке или церковном богослужении, если с помощью инструментов big data и нейронных сетей проанализируем древнерусские рукописи традиционного содержания, то есть книги, входящие в основной богослужебный круг – Служебник, Минея, Постная и Цветная Триодь, Паримейник, Служебное Евангелие, Следованная Псалтырь? Казалось бы, это должны быть однотипные и идентичные по содержанию источники. Но не всё так просто. Александр Геннадьевич Кравецкий, ведущий эксперт Лаборатории цифровых технологий в гуманитарных науках НИЯУ МИФИ и ведущий научный сотрудник Отдела лингвистического источниковедения и истории русского литературного языка Института русского языка им. В.В. Виноградова РАН рассказывает, как исследовать такие источники и к каким открытиям это может привести.
Первоначально интервью вышло в издании «Коммерсант».
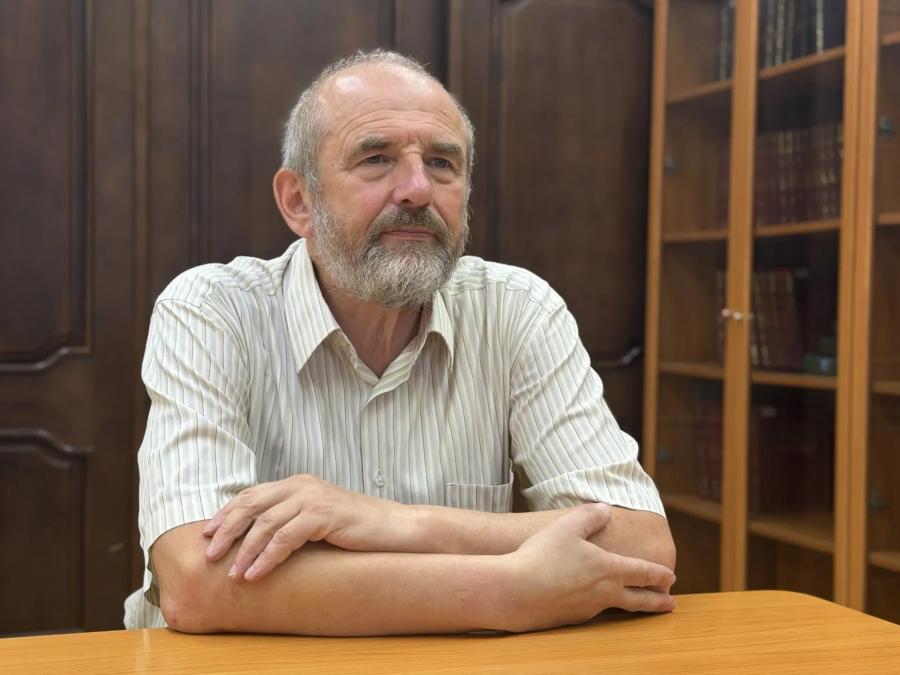
- Александр Геннадьевич, как вообще возникла эта задача?
- С 2022 года в НИЯУ МИФИ в Лаборатории цифровой лингвистики Института фундаментальных проблем социо-гуманитарных наук НИЯУ МИФИ разрабатывается лингвистическая интеллектуальная среда (ЛИС) «Рукописное наследие Древней Руси», которая будет способна распознавать церковнославянские рукописи XI-XVIII веков и представлять их выборку под конкретный запрос. ЛИС создается как человеко-машинный интерфейс с элементами самообучения, то есть в нее можно будет постоянно добавлять новые рукописи, которые искусственный интеллект будет распознавать и при этом постоянно подстраивать свои алгоритмы распознавания. Несколько лет назад иеромонах Родион (Алексей Ларионов), директор Института фундаментальных проблем социогуманитарных наук НИЯУ МИФИ, спросил меня, что в той области, которой мы занимаемся, могут дать программисты, какой инструмент IT был бы нам полезен. И мы предложили проект с условным названием «Рабочее место филолога-древника» с личным кабинетом для каждого исследователя.
- Чем можно заниматься, сидя на этом «рабочем месте»?
Есть такой тип письменных памятников, которые называют памятники традиционного содержания в первую очередь это богослужебные книги, их состав более-менее стандартен и их много, ведь они должны были быть в каждой церкви: если «Слова о полку Игореве» не сохранилось ни одного экземпляра, летописей сохранились десятки, то количество богослужебных сохранившихся богослужебных книг измеряется тысячами. Тексты, входящие в эти книги, переписывались и редактировались на протяжении столетий, поэтому они отражают особенности региональных письменных традиций, диалектов, богослужебных особенностей и т.д. А поскольку состав таких книг относительно стабилен, их очень удобно сравнивать между собой.
Начать мы решили со Служебных миней – книг, содержащих службы на каждый день церковного года. Это 12 объемных томов – по тому на каждый месяц. А поскольку каждый из этих томов сохранился в десятках, а то и в сотнях экземпляров, у нас есть достаточно объемный корпус текстов для анализа.
- Писцы ведь могут делать как обычные ошибки, так и намеренно изменять исходный текст?
- Конечно, ошибка ошибке рознь. Но вот, например, человек пишет слово «корова» как «кАрова», и мы понимаем, что это не может быть намеренно – такую ошибку не сделает человек окающих говоров, а значит, это писалось не на севере и не в Поволжье. Если он выговаривает «о» – «кОрова» – то он никогда не напишет «кАрова». И соответственно по этим ошибкам или, скажем помягче, местным орфографическим особенностям, можно узнать много интересного для атрибутации рукописи, ведь в большинстве случаев у нас нет ничего – ни даты ее создания, ни места.
А кроме условной «каровы-коровы» в таких памятниках можно еще увидеть варианты редактирования. Структура богослужения похожа на конструктор лего – стандартные элементы - тропари, кондаки, каноны и т.д. компануются в зависимости от дня церковного года, удаленности от даты Пасхи и т.д. Эти сравнительно небольшие элементы очень удобно сравнивать друг с другом. А искусственный интеллект позволяет провести такое сравнение на сотнях примеров, в то время как человек способен проанализировать и сравнить меду собой в лучшем случае лишь несколько десятков книг.
- Казалось бы, минеи – вещь типовая, но, оказывается, может служить основой для анализа древних нетиповых текстов, скажем, художественных. Какие там могут быть открытия?
- Можно увидеть, как более поздние авторы заимствовали какие-то элементы у более ранних, что переписывали без изменений, а что редактировали…
- И наконец, мы все-таки сможем, благодаря ИИ, узнать – подлинником было «Слово о полку Игореве» или фальшивкой?
- Ну вопрос про подлинность «Слова» после книги А.А. Зализняка все-таки кажется закрытым. Хотя какие-то скрытые аллюзии и текстовые пересечения с классическими и вроде бы хорошо изученными древнерусскими текстами вполне могут быть обнаружены. Но это в будущем. Пока мы в самом начале этого пути. Пока у нас есть огромное количество рукописных книг, состав которых, в лучшем случае, описан так: «1 июня служба такая-то, 2 июня служба такая-то». А о различиях состава этих служб в разных рукописях мы не знаем. Ведь кроме ошибок переписчиков и мелких текстовых изменений в истории богослужебной письменности предпринимались и крупные исправления книг. Такое происходило не только в XVII веке при патриархе Никоне, но и раньше. Поэтому выловлено будет много неожиданного.
- Расскажите о методиках отлова неожиданностей.
- Самое простое и формальное – внешний облик букв. Особенности почерка позволяют датировать рукописи и определять место ее написания. Эти методы уже давно используют для датировки рукописей. Почерки недатированных рукописей сравниваются с почерками рукописей, для которых известна точная дата написания и на основании близости почерка делается вывод о близости времени написания. Этим занимается палеография. Но палеография рассчитана на человеческое восприятие, а возможности человеческой памяти ограничены. В случае же машинного анализа мы теоретически можем сравнивать все написания датированных рукописей со всеми написаниями недатированных.
- А сколько уже миней оцифровано?
- Небольшая часть. В нашем распоряжении 247 рукописей, оцифрованных архивами. Это более 110.000 страниц. Это объем, достаточный для создания инструментов работы с рукописями традиционного содержания. Ну дальше начнутся проблемы, которые будем решать уже не мы – финансовые, юридические и т.д.
- Представим идеальную картину мира: вы оцифровали и разобрали по буковкам достаточное для построения лингвистической машинной системы количество миней, проанализировали их, увидели какие-то закономерности. На что еще можно направить этот инструмент анализа?
- Глобальный ответ – на все письменные памятники. Благодаря подобным инструментам исследователи смогут точнее понять какие происходили изменения в языке, как менялась его лексика и орфография. А для начала – на рукописи аналогичных структур, то есть состоящие из фрагментов, организованных по какому-то принципу. Например, на другие богослужебные книги: триоди, прóлоги (сборники житий). И когда весь этот массив мы уже как-то осознаем, можно будет обратиться к уникальным источникам, летописям. И наверняка в условном «Слове о полку Игореве» мы таким образом откопаем десяток цитат. Хотя, казалось бы, уж оно изучено вдоль и поперек. Дело в том, что уникальные вещи мы знаем относительно неплохо, а массовые – плохо. Но ведь они взаимосвязаны, в уникальных вещах может быть огромное количество следов из массовых текстов. Для наглядности можно привести пример из нашего времени: поэтическая книга, изданная тиражом 20 экземпляров, до потомков дойдет, потому что сохранится в библиотеках, а рекламная брошюра, слоган из которой может быть использован в этой поэтической книге, – нет, хотя она напечатана миллионным тиражом. И будущим комментаторам условного Пелевина будет очень трудно понять, «из какого сора» у него все росло. Всегда же есть тексты (или скажем, рекламные ролики), которые на слуху, но пройдет время, и через два поколения уже никто не будет их помнить. И поэтому понять, что они значили в контексте, будет трудно.
- С какими проблемами вам приходится сталкиваться в техническом плане, что затрудняет обработку изображений? Нечеткость букв, почерка, старость или засаленность бумаги?
- Перечисленное вами – не главные проблемы. Главная – огромная вариативность написания букв и сокращений (титлов). Не говоря уже о буквицах. Самый простой пример – похожесть буквы «и» и «н». Или написание буквы «К» – кто-то пишет ее как палочку слева и две диагонали из центра, а кто-то – как палочку и скобочку справа, то есть I<. Плюс особенности оформления рукописей, надстрочные знаки, нотные знаки – это вообще отдельная огромная тема. Затем, есть масса неожиданных сокращений или оборванный текст: когда вместо общеизвестного песнопения приводится «зачало» – два-три первых слова. Подразумевается, что дальше и так все понятно и не обязательно переводить чернила и бумагу… То есть машина должна не только правильно прочитать буквы, но и понять, что далее текст обрывается. Это очень большой объем работы.
- Здесь, верно, нельзя обойтись без верификатора, чтобы проверить, правильно ли машина прочитала.
- Да, без этого нельзя обойтись, в этой истории от «кожаных мешков» никуда не деться.
- За рубежом как обстоят дела с распознаванием древних текстов?
- Чтобы был проект подобный нашему «Рабочему месту филолога», я не слышал. Но вообще по распознаванию средневековых текстов есть прекрасно работающая немецкая система «Transkribus», правда, она коммерческая и недешевая. Для массового распознавания, как в нашем случае, это просто очень дорого. Но, конечно, мы на их опыт оглядываемся.
- Какая строится работа в проекте и какая стадия сейчас?
- Мы просматриваем имеющиеся у нас оцифрованные минеи на предмет разных почерков и составляем каталог для каждой буквы или знака – «вырезаем» изображения этих элементов, несколько сот изображений получается для каждой буквы или знака.
Мы уже научились очищать текст и выпрямлять строки – последнее особенно важно для машины. При фотографировании строки смешаются. Человеку это почти не мешает, а вот работу машины сильно усложняет. Накопленный материал скармливается разным моделям искусственного интеллекта, созданным в МИФИ. Пока идет стадия накопления материала и мячик на стороне программистов. С буковками мы разобрались, теперь с ними разбирается машина. Мы ждем, когда у нас будет «текст», который мы сможем верифицировать, опознать ошибки и начать обучать машину, то есть править коды распознавания изображений. Это долгая работа, требующая сил, времени и финансирования. Кстати, это касается всех проектов, направленных на обработку плохо структурируемого гуманитарного материала
- Но вы же сказали, что это как лего, значит, структурируемого все-таки?
- Представьте, что у нас много кубиков лего, которые подходят друг к другу по форме, но внутри каждого кубика хаос со стремящимся к бесконечности списком элементов, которые нам нужно все-таки как-то типизировать.
- Как бы вы образно описали свою работу?
- Как путешествие хоббитов, когда главная задача – доползти до ближайшего куста и выжить. Ну а дальше можно подумать, как добраться до следующего куста.
Беседовала Ксения Ерохина
81